Một sản phẩm AI thực sự tốn tiền ở đâu?
Chi phí sản phẩm AI không chỉ là giá gọi model; một yêu cầu còn kéo theo nạp dữ liệu, lưu trữ, truy xuất, gọi công cụ, thử lại và vận hành hệ thống.
Một người dùng upload vài tài liệu, gõ một câu hỏi và vài giây sau nhận được câu trả lời dựa trên chính những tài liệu đó. Nhìn từ giao diện, đây chỉ là một hành động: hỏi AI. Nhưng nếu muốn biết sản phẩm đó thực sự tốn bao nhiêu tiền, “một câu hỏi” là đơn vị quá thô. Trước khi câu hỏi đầu tiên xuất hiện, hệ thống có thể đã phải lưu file, đọc nội dung, chia tài liệu thành các đoạn nhỏ, tạo embedding và xây chỉ mục tìm kiếm. Khi người dùng hỏi, hệ thống còn có thể truy xuất dữ liệu, ghép context, gọi model, gọi thêm công cụ, thử lại khi lỗi và ghi log để đội vận hành biết chuyện gì đã xảy ra. Vì vậy, câu hỏi hữu ích hơn không phải là “API của model giá bao nhiêu?” mà là:
Một hành động của người dùng khiến hệ thống phải làm những công việc nào, và mỗi công việc tăng theo biến gì?
Đó là mental model của bài này.
1. Một hành động của người dùng, ba đường chi phí
Ở Pilot 01, Học Tech đã nhìn AI từ lớp hạ tầng vật lý: inference cuối cùng vẫn phải chạy trên phần cứng thật. Bài này bắt đầu ở lớp cao hơn — bài toán chi phí ở tầng ứng dụng. Một sản phẩm AI hỏi đáp trên tài liệu có thể được nhìn qua ba đường chi phí:
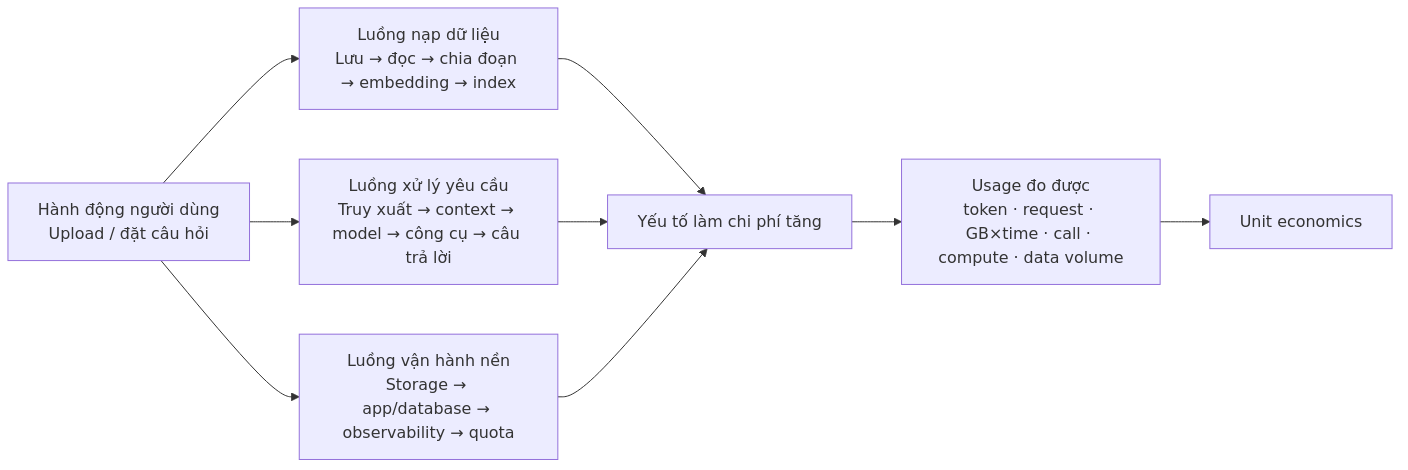
Ba đường này là các lớp công việc logic, không phải ba dòng bắt buộc phải xuất hiện trên hóa đơn. Một dịch vụ quản lý sẵn có thể gộp nhiều việc thành một mức phí; một kiến trúc tự ghép có thể làm từng việc xuất hiện thành dịch vụ riêng. Từ đây, ta có thể hỏi đúng hơn: mỗi lớp tăng theo token, số request/query, số trang tài liệu, dung lượng lưu trữ theo thời gian, số lần gọi công cụ, compute time hay data volume? Đó là các yếu tố làm chi phí tăng — hay cost driver.
2. Chi phí bắt đầu trước cả câu hỏi đầu tiên
Giả sử người dùng upload một file PDF để sau này đặt câu hỏi dựa trên nội dung của nó. Một hệ thống RAG — retrieval-augmented generation, tức lấy dữ liệu liên quan trước rồi đưa vào model để tạo câu trả lời — thường có những công việc như: Upload → lưu file → parse/OCR nếu cần → chia đoạn → embedding → index Không phải hệ thống nào cũng dùng đúng các bước hay đúng dịch vụ như nhau. Nhưng những công việc này giúp ta nhìn ra yếu tố chi phí. Lưu file. Tài liệu gốc phải tồn tại ở đâu đó. Object storage có thể tạo phí theo dung lượng, request/retrieval và data transfer tùy provider và storage class. Amazon S3 là một ví dụ có các billing dimension này. AWS — S3 Pricing Đọc và chia tài liệu. Nếu PDF có text sẵn, ứng dụng có thể parse bằng thư viện. Nếu là scan, có thể cần OCR. Nếu dùng dịch vụ xử lý tài liệu được quản lý sẵn, chi phí có thể được tính theo số trang. Google Cloud Document AI hiện có các processor tính theo page/count; Azure Document Intelligence cũng theo dõi số trang được xử lý để ước lượng chi phí. Google Cloud — Document AI pricing, Microsoft — Document Intelligence cost estimation Nếu tự chạy parser trên application server, bạn có thể không thấy một dòng “document parsing” trên hóa đơn. Công việc vẫn tồn tại; chỉ là chi phí đã chuyển vào compute của ứng dụng. Embedding và indexing. Embedding biến text thành một biểu diễn dạng vector để hệ thống có thể tìm các đoạn có nội dung gần nhau. Embedding API có thể được tính theo input token; vector database có thể tính theo storage, read/write unit hoặc egress. OpenAI và Pinecone hiện là hai ví dụ cho các billing dimension khác nhau. OpenAI — text-embedding-3-small, Pinecone — Pricing Ngược lại, một dịch vụ retrieval được quản lý sẵn có thể bundle parsing, chunking, embedding và index storage thành một sản phẩm. OpenAI File Search là một ví dụ có phí vector storage và phí theo lần file-search call. OpenAI — File Search pricing FAQ, OpenAI — Responses API tools Vì thế, câu hỏi nên là:
Bao nhiêu dữ liệu mới hoặc thay đổi? Bao nhiêu dữ liệu phải xử lý lại? Bao nhiêu state phải được giữ trong bao lâu?
Đó là yếu tố chi phí của luồng nạp dữ liệu.
3. Một câu hỏi nhỏ có thể trở thành một request lớn
Khi tài liệu đã được chuẩn bị, đường đi của một câu hỏi có thể là: Question → retrieval → context → model input → model output Người dùng chỉ nhìn thấy một câu hỏi. Hệ thống lại có nhiều lớp công việc hơn.
Retrieval làm tăng công việc trước khi model chạy
Ứng dụng có thể thực hiện một hoặc nhiều truy vấn để lấy những đoạn liên quan. Dịch vụ retrieval có thể tính theo query, read unit hoặc tool call tùy kiến trúc. Nếu một flow search hai lần thay vì một lần, số người dùng không đổi nhưng lượng công việc đã tăng.
Context thường lớn hơn nhiều so với câu người dùng gõ
Những đoạn được retrieval không trở nên miễn phí chỉ vì chúng đã nằm trong database. Khi được ghép vào prompt, chúng trở thành input mà model phải xử lý. Một request có thể chứa system instructions, conversation history, retrieved chunks, tool schemas và dữ liệu từ những bước trước. OpenAI cũng lưu ý token usage có thể bao gồm nhiều cấu trúc hơn plain text người dùng nhập. OpenAI — Understanding and counting tokens Đây là context amplification: một hành động nhỏ của người dùng có thể biến thành lượng model input lớn hơn nhiều.
Output cũng là workload
Nhiều model/API hiện có mức giá output khác input; trong một số trường hợp output đắt hơn input. Vì vậy yêu cầu câu trả lời dài hơn không chỉ thay đổi trải nghiệm mà còn thay đổi usage. OpenAI — GPT-5.6 Luna, Anthropic — Pricing Cùng số user và cùng số request, nhưng response trung bình dài gấp đôi có thể tạo model cost rất khác.
Caching có thể giảm một phần công việc lặp lại — nếu workload phù hợp
Google Gemini và Anthropic đều có cơ chế context/prompt caching, nhưng cách tính cache write/read, TTL và điều kiện cache hit khác nhau. Google — Gemini context caching, Anthropic — Prompt caching Vì vậy cache không phải một nút “bật lên là rẻ”. Nó chỉ giúp khi context thực sự được tái sử dụng đủ nhiều theo cơ chế của provider. Và nó không loại bỏ các lớp chi phí khác như retrieval, output, storage hay observability.
4. Một hành động có thể bị khuếch đại thành nhiều vòng xử lý
Đến đây, luồng xử lý yêu cầu vẫn có vẻ khá tuyến tính. Nhưng tools, agent loops và retry có thể làm một hành động của người dùng nở ra thành nhiều lượt xử lý. Một flow đơn giản có thể là: 1 user action → 1 retrieval → 1 model call Một flow khác có thể là: 1 user action → 2 retrievals → 3 model rounds → 2 tool calls Hai flow này không nên được ước lượng bằng cùng một con số “cost per request”. Anthropic mô tả tool-use request vẫn dùng input/output token; tool schema và tool result cũng đi vào context, trong khi một số server-side tools còn có usage-based charge riêng. Anthropic — Tool use Điều đó không có nghĩa agent luôn đắt hơn chatbot. Nó có nghĩa số vòng xử lý là một yếu tố chi phí cần đo. Retry cũng vậy. Không nên tự mặc định rằng mọi failed request đều bị tính phí. Google Cloud Document AI nêu 4xx/5xx failed requests không bị bill; Anthropic nói failed API requests nói chung không bị charge nhưng disconnect/timeout trong một request đang thực thi có thể vẫn phát sinh charge. Billing behavior phụ thuộc provider và loại lỗi. Google Cloud — Document AI pricing, Anthropic — API billing Vì thế, khi ước lượng production cost, nên đo số lần thực thi thực tế và usage thực sự bị tính phí, thay vì tự cộng một tỷ lệ retry cố định cho mọi request.
5. Có những chi phí tồn tại ngay cả khi model không chạy
Request kết thúc không có nghĩa toàn bộ chi phí kết thúc. Một AI product vẫn là một software product. Nó có thể cần:
- relational database cho user, permissions và document metadata;
- object/vector storage giữ dữ liệu theo thời gian;
- application server hoặc serverless functions;
- networking và data transfer;
- logging, metrics và tracing;
- quota, rate limits và abuse controls.
Observability — khả năng quan sát hệ thống qua log, metric và trace — là một ví dụ dễ bỏ qua. Google Cloud Observability hiện tính phí các sản phẩm Logging, Monitoring và Trace theo những dimension như GiB dữ liệu, metric samples hoặc trace spans. Google Cloud Observability — Pricing Do đó hai ứng dụng dùng cùng model và cùng số token vẫn có thể có chi phí vận hành khác nhau nếu một ứng dụng ghi log dày hơn, giữ log lâu hơn hoặc tạo nhiều telemetry hơn. Ở lớp này, quota và rate limit cũng cần được hiểu đúng. Chúng có thể giúp giới hạn workload hoặc phát hiện abuse, nhưng một budget alert không mặc nhiên là hard spending cap. Cơ chế cụ thể phải được kiểm tra theo provider. OpenAI — Managing projects
6. Một phép tính nhỏ: cùng 1.000 người dùng, hai mức cost khác nhau
Phép tính sau chỉ là provider-specific price snapshot tại ngày 17/09/2026, dùng để minh họa cơ chế. Nó không phải industry average và không phải “chi phí chuẩn” cho AI app. Giả sử một document-Q&A app có 1.000 monthly active users, mỗi người hỏi 20 câu/tháng, tức 20.000 câu hỏi. Base case dùng:
- 4.000 input tokens/câu;
- 500 output tokens/câu;
- 1 File Search call/câu;
- vector store trung bình 5 GB trong 30 ngày;
- GPT-5.6 Luna + OpenAI File Search;
- không tính caching.
Tại thời điểm snapshot, GPT-5.6 Luna công bố giá 0,20 USD/1M input tokens, 0,02 USD/1M cached input tokens và 1,20 USD/1M output tokens. OpenAI File Search công bố 2,50 USD/1.000 calls và vector storage 0,10 USD/GB/day, với 1 GB đầu tiên miễn phí. OpenAI — GPT-5.6 Luna, OpenAI — Responses API tools
| Khoản tính | Base case | Workload nặng hơn |
|---|---|---|
| Input | 80M tokens → 16 USD | 160M tokens → 32 USD |
| Output | 10M tokens → 12 USD | 20M tokens → 24 USD |
| File Search | 20.000 calls → 50 USD | 40.000 calls → 100 USD |
| Vector storage | 4 GB billable × 30 ngày → 12 USD | 4 GB billable × 30 ngày → 12 USD |
| Subtotal | 90 USD/tháng | 168 USD/tháng |
Ở cột thứ hai, số user vẫn là 1.000 và số câu hỏi vẫn là 20.000. Chỉ có lượng công việc cho mỗi hành động tăng: input lên 8.000 tokens, output lên 1.000 tokens và retrieval lên hai calls/câu. Subtotal tăng từ 90 lên 168 USD dù user count không đổi. Con số này chưa tính document processing, raw object storage, application/database infrastructure, observability, network, retries hay support. Giá provider cũng có thể thay đổi, nên cần kiểm tra lại trước khi xuất bản hoặc dùng cho estimate thực tế. Điều đáng nhớ không phải là 90 USD. Điều đáng nhớ là: cùng số người dùng, workload khác thì economics khác.
7. Framework thực hành: estimate từ công việc hệ thống thực hiện
Khi cần ước lượng một AI feature, có thể bắt đầu bằng năm bước. Bước 1 — Chọn một hành động của người dùng. Ví dụ: “người dùng hỏi một câu dựa trên tài liệu đã upload”. Bước 2 — Vẽ ba đường chi phí. Luồng nạp dữ liệu, luồng xử lý yêu cầu và luồng vận hành nền. Bước 3 — Gắn yếu tố chi phí cho từng việc. Token? Query? Tool call? Page processed? GB×time? Compute time? Data volume? Bước 4 — Ghi assumptions bằng đơn vị đo được. Không viết “1 user = X USD”. Hãy viết kiểu “20 câu hỏi/user/tháng × 4.000 input tokens/câu × rate”. Bước 5 — Thay assumptions bằng usage quan sát được càng sớm càng tốt. Khi có workload đại diện hoặc production telemetry, estimate nên dựa trên phân bố thực tế thay vì chỉ một average đẹp trên spreadsheet. Có thể tóm tắt bằng: Monthly cost ≈ ingestion + standing state + Σ(user actions × work per action × applicable rates) Đây không phải universal calculator. Free allowance, minimum spend, tier, capacity reservation hay negotiated pricing đều có thể làm hóa đơn thực tế khác công thức đơn giản này.
8. Nhiều người dùng hơn có làm unit economics tốt hơn không?
Không tự động. Nếu mỗi user mới kéo theo gần như cùng lượng model tokens, retrieval, tool calls và storage, nhiều user đồng nghĩa nhiều variable usage hơn. Nếu product giữ ngày càng nhiều tài liệu, storage còn có thể tăng theo thời gian chứ không chỉ theo request. Nếu workflow dùng nhiều tool rounds hơn hoặc context ngày càng dài, chi phí cho mỗi kết quả hữu ích thậm chí có thể tăng nhanh hơn user count. Nhưng chiều ngược lại cũng có thể xảy ra. Repeated context có thể tận dụng caching. Context và output có thể được rút gọn mà vẫn giữ chất lượng. Workflow có thể giảm số retrieval hoặc tool round. Một baseline infrastructure cost có thể được chia trên nhiều kết quả hữu ích hơn. Vì vậy scale không phải một phép nhân đơn giản và cũng không bảo đảm economies of scale. Còn một nuance quan trọng: average có thể che distribution. Nếu phần lớn user tạo workload nhẹ nhưng một nhóm nhỏ upload tài liệu rất lớn, dùng context rất dài hoặc kích hoạt nhiều vòng agent/tool, chi phí thật có thể bị quyết định bởi “đuôi dài” của workload. Vì thế economics trong production cần nhìn percentile hoặc cohort phù hợp, không chỉ một average request đẹp. “Useful outcome” ở đây cũng không phải KPI chung cho mọi sản phẩm. Mỗi product phải tự định nghĩa kết quả hữu ích là gì: một câu trả lời được chấp nhận, một task hoàn thành, một ticket được xử lý hay một workflow thành công. Câu hỏi cần theo dõi là:
Khi số người dùng tăng, lượng công việc cần thiết để tạo ra một kết quả hữu ích thay đổi như thế nào?
9. Điều nên giữ lại
Một AI product không có một “giá API” duy nhất. Mental model hữu ích hơn là: Hành động người dùng → công việc hệ thống → yếu tố làm chi phí tăng → usage đo được → unit economics. Số người dùng chỉ là điểm bắt đầu. Để biết sản phẩm thực sự tốn tiền ở đâu, cần nhìn xem mỗi người dùng khiến hệ thống phải xử lý bao nhiêu dữ liệu, gọi bao nhiêu dịch vụ, thực hiện bao nhiêu vòng và giữ bao nhiêu state trong bao lâu. Vì thế trước khi tối ưu chi phí, việc đầu tiên không nên là tìm model rẻ nhất. Việc đầu tiên là vẽ đúng đường đi của workload.