Làm sao xây AI agent an toàn khi nó có thể dùng công cụ và thực hiện tác vụ dài?
Agent an toàn cần giới hạn nơi quyết định của model biến thành hành động thật: phạm vi quyền, sandbox, phê duyệt, giới hạn tài nguyên, quan sát và phục hồi.
Ở bài trước, Học Tech dùng một ranh giới khá hữu ích để nhìn AI agent: model không chỉ tạo câu trả lời mà còn có thể quyết định bước tiếp theo trong một vòng lặp hành động. Nhưng khi “bước tiếp theo” chỉ là tìm thêm một đoạn tài liệu, hậu quả của một quyết định sai rất khác so với khi bước đó là ghi file, chạy lệnh shell, gọi API có thông tin xác thực hoặc tạo một thay đổi bên ngoài hệ thống. Từ đây, bài toán an toàn không còn chỉ là:
Làm sao để model quyết định đúng?
Nó còn là:
Nếu model quyết định sai, hệ thống cho phép quyết định đó biến thành hành động thật tới đâu?
Đó là mô hình tư duy trung tâm của bài này.
1. An toàn của agent bắt đầu ở nơi quyết định biến thành hành động
Một model có thể đề xuất rất nhiều thứ. Nhưng chính hệ thống xung quanh model mới quyết định đề xuất nào thực sự được biến thành quyền đọc, ghi, thực thi hoặc tác động ra bên ngoài. Có thể hình dung luồng này như sau:
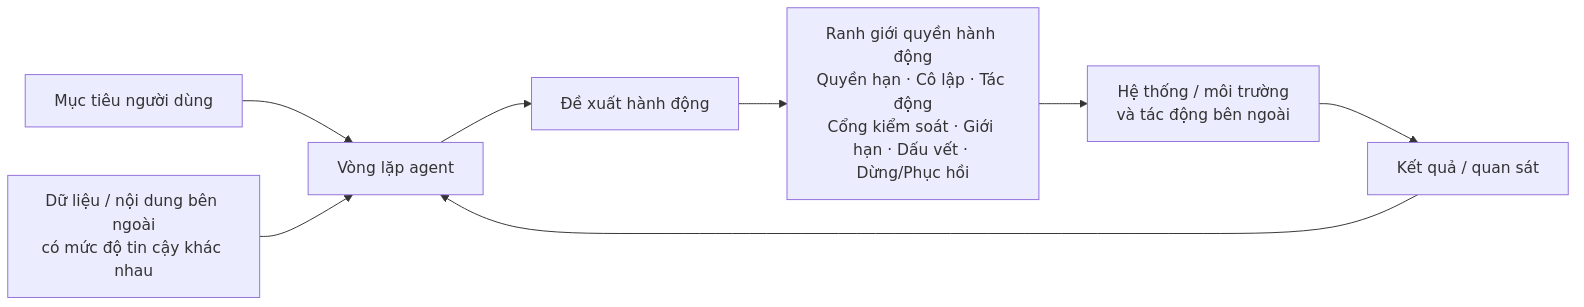
Trong bài này, quyền hành động (capability) là một khả năng mà hệ thống thực sự cấp cho agent: đọc một thư mục, ghi file, thực thi lệnh, gọi một API, truy cập database, gửi dữ liệu ra ngoài hoặc giao việc cho một agent khác. Điểm quan trọng là capability không chỉ là tên một tool. Một tool read_file chỉ có ý nghĩa an toàn khi ta biết nó được đọc file nào, dưới danh tính nào, trong môi trường nào và kết quả đó sau đó có thể đi tới đâu. Tương tự, một tool run_shell không tự nó nói cho ta biết agent chạy trong một working directory cô lập hay trên chính host đang giữ thông tin xác thực (credential) của production. Đây cũng là lý do guardrail ở lớp model không đủ để thay thế các lớp kiểm soát của hệ thống. OpenAI mô tả guardrail như một phần của layered defense và nói chúng nên đi cùng authentication, authorization, access control và các biện pháp security phần mềm thông thường. NIST cũng lưu ý trong phân tích về agentic AI ngày 27/8/2026 rằng các thách thức mới của agent không thể chỉ dựa vào “model-only” guardrails. (OpenAI — A practical guide to building agents, NIST — Why Agentic AI Needs a Strong Identity Foundation) Vì vậy, câu hỏi thiết kế hữu ích hơn là: mỗi quyền hành động phải đi qua ranh giới nào trước khi tạo ra tác động thật?
2. Một khung thực hành: Capability Contract
Phần sau là khuyến nghị thực hành của Học Tech, tổng hợp từ các pattern trong tài liệu security, protocol và agent runtime hiện hành. Capability Contract không phải tên của một formal standard hay một permission model chuẩn của ngành. Có thể hiểu nó như một “hợp đồng” cần xác định trước cho từng quyền hành động mà agent được cấp.
| Trường | Câu hỏi cần trả lời |
|---|---|
| 1. Quyền hạn (Capability & Authority) | Agent được đọc/ghi/thực thi/gọi gì? Dưới danh tính nào? Trên tài nguyên nào? Credential tồn tại bao lâu? |
| 2. Ranh giới thực thi (Execution Boundary) | Tool hoặc code chạy ở đâu? Nó nhìn thấy filesystem, network, process và secret nào? |
| 3. Tác động & lặp lại (Side Effect & Replay) | Hành động chỉ đọc, thêm mới, phá hủy hay tác động ra bên ngoài? Nếu lặp lại cùng action thì chuyện gì xảy ra? |
| 4. Cổng kiểm soát (Gate) | Authorization, validation, policy hoặc phê duyệt của con người nằm ở đâu? |
| 5. Giới hạn tài nguyên (Budget) | Giới hạn lượt chạy, thời gian, token, tool call, concurrency, tiền, rate, memory hoặc network nào cần áp dụng? |
| 6. Dấu vết (Evidence) | Cần lưu gì để biết actor nào đã làm action nào, với input/policy/approval nào và kết quả ra sao? |
| 7. Dừng & phục hồi (Stop & Recovery) | Agent dừng ở đâu? Có resume/checkpoint không? Retry có an toàn không? Tác động đã xảy ra được xử lý thế nào? |
Không phải capability nào cũng cần cùng mức kiểm soát. Một agent chỉ đọc một thư mục tài liệu công khai không có cùng threat model với một agent có quyền gửi email, truy cập dữ liệu khách hàng và thực thi code. Mức nhạy cảm của dữ liệu và mức tin cậy của nguồn bên ngoài là bối cảnh làm thay đổi contract, không phải một checkbox giống nhau cho mọi agent. Và checklist này cũng không chứng minh một agent “an toàn tuyệt đối”. Kiểm soát phù hợp còn phụ thuộc threat model, dữ liệu, hệ thống downstream và hậu quả nếu action sai.
3. Xác thực trả lời “ai”; phân quyền trả lời “được làm gì”
Một distinction dễ bị làm mờ trong hệ thống agent là xác thực (authentication) và phân quyền (authorization). NIST định nghĩa authentication là quá trình xác minh identity của user, process hoặc device; authorization liên quan tới việc cho phép hoặc từ chối một action/access cụ thể đối với tài nguyên. (NIST — Authentication glossary, NIST — Authorization glossary) Nói ngắn gọn:
Xác thực: Đây là ai?
Phân quyền: Thực thể này được phép làm gì trên tài nguyên này?
Một agent có token hợp lệ không đồng nghĩa agent nên được gọi mọi endpoint mà token đó có thể chạm tới. NIST trong bài phân tích tháng 8/2026 nhấn mạnh rủi ro từ credential dùng chung, credential sống lâu và quyền truy cập quá rộng trong agentic systems. RFC 9700, trong khi đó, là Best Current Practice cho security của OAuth 2.0 nói chung; nó không phải “chuẩn authorization dành riêng cho AI agent”, nhưng là một nền security có liên quan khi agent truy cập API qua OAuth. (NIST — Strong Identity Foundation, RFC 9700 — Best Current Practice for OAuth 2.0 Security) Từ góc nhìn thiết kế, một contract tốt thường cố làm quyền của agent hẹp hơn quyền tối đa mà hạ tầng có thể cấp. Ví dụ, một coding agent làm việc trên một repository có thể cần quyền tạo branch và mở pull request, nhưng không nhất thiết cần token có quyền quản trị organization hoặc deploy thẳng production. Đây là ứng dụng của nguyên tắc quyền tối thiểu vào workflow cụ thể, không phải tuyên bố rằng có một permission schema duy nhất cho mọi agent.
Prompt và metadata không phải ranh giới phân quyền
MCP hiện có các annotation như readOnlyHint, destructiveHint, idempotentHint và openWorldHint để mô tả rủi ro của tool. Nhưng chính tài liệu MCP nói rõ đây là hints: chúng có thể hỗ trợ UI, confirmation hoặc policy engine, nhưng không phải guarantee rằng tool thật sự chỉ đọc hay thật sự idempotent. Hard guarantee phải nằm ở authorization, transport, runtime, network control hoặc sandbox thích hợp. (MCP — Tool Annotations as Risk Vocabulary) Cùng logic đó, một system prompt ghi “không được xóa file” có thể giúp model chọn hành động tốt hơn, nhưng nó không tương đương với việc process thực thi không có quyền xóa file. Một bên là instruction. Một bên là enforcement.
4. Sandbox trả lời “chạy ở đâu”, không trả lời “được phép làm gì”
“Chạy agent trong sandbox” thường được dùng như một câu trả lời ngắn cho bài toán an toàn. Nhưng sandbox và permission model giải quyết hai câu hỏi khác nhau.
- Phân quyền: thực thể này có quyền thực hiện action nào trên tài nguyên nào?
- Sandbox / cô lập thực thi: action đó được thực thi trong môi trường nào và môi trường ấy nhìn thấy những gì?
Một implementation case cho distinction này là OpenAI Agents SDK. UnixLocalSandboxClient thuận tiện cho development nhưng command vẫn chạy như local host process, có local filesystem và network access. Khi cần isolation mạnh hơn, tài liệu hướng tới Docker hoặc hosted sandbox; Docker còn có thể tắt network với network_mode="none". (OpenAI Agents SDK — Sandbox clients) Case này không đại diện cho mọi framework. Nhưng nó cho thấy một nguyên tắc rộng hơn:
Tên “sandbox” không đủ. Cần biết boundary thực sự của sandbox là gì.
Nếu agent chạy code trong container nhưng mount toàn bộ home directory ở chế độ ghi và có network + cloud credential production, “có container” chưa cho biết phạm vi ảnh hưởng đã giảm tới đâu. Ngược lại, một sandbox cô lập mạnh cũng không tự quyết định user nào được phép yêu cầu agent đọc dataset nào. Isolation không thay authorization.
5. Tác động của action quyết định nơi nào cần cổng kiểm soát
Không phải mọi tool call đều cần phê duyệt của con người (human approval). Một hệ thống yêu cầu người dùng bấm “Approve” cho từng lần đọc file, từng truy vấn database và từng lệnh test có thể trở nên chậm tới mức con người bắt đầu duyệt theo thói quen thay vì thực sự kiểm tra. Các agent runtime có thể hỗ trợ pause/resume cho sensitive tool call, còn guide xây agent của OpenAI nêu high-risk action và việc vượt failure threshold như các trigger điển hình cho human intervention. Đây là implementation guidance, không phải quy tắc bắt buộc cho mọi hệ thống. (OpenAI Agents SDK — Human in the loop, OpenAI — A practical guide to building agents) NIST đồng thời cảnh báo rằng lạm dụng Human-in-the-Loop có thể tạo consent fatigue: user bị hỏi quá thường xuyên đến mức phản xạ “allow” chỉ để workflow tiếp tục. (NIST — Strong Identity Foundation) Vì vậy, approval hợp lý hơn khi nó đặt tại ranh giới của một tác động có consequence đáng kể, thay vì xuất hiện cho mọi action. Một cách phân loại thực dụng là hỏi:
- Action chỉ đọc hay thay đổi trạng thái?
- Nếu thay đổi, nó là additive hay destructive?
- Nó chỉ thay đổi workspace tạm thời hay tạo tác động ngoài hệ thống như gửi email, mở ticket, thanh toán hoặc publish?
- Nếu chạy hai lần, nó có tạo hai side effect không?
- Có thể hoàn tác hoặc bù trừ tác động không?
MCP dùng readOnly, destructive, idempotent và open-world như một vocabulary rủi ro tương tự, nhưng nhấn mạnh rằng risk còn phụ thuộc vào sự kết hợp của nhiều tool trong cùng session, không chỉ một tool đứng riêng. (MCP — Tool Annotations as Risk Vocabulary) Điều này đặc biệt rõ với prompt injection. Một email độc hại hoặc một trang web chứa instruction không tự nó có quyền lấy dữ liệu. Tác động lớn xuất hiện khi nội dung không đáng tin được kết hợp với capability có thể đọc dữ liệu riêng tư và capability có thể gửi dữ liệu hoặc tạo external side effect. OpenAI mô tả cách nhìn này bằng source–sink analysis: phòng thủ không chỉ cố nhận diện mọi prompt injection mà còn phải hạn chế tác động nếu model bị steer sai. (OpenAI — Designing AI agents to resist prompt injection) Vì vậy, câu hỏi không chỉ là “tool này có nguy hiểm không?” mà là:
Tool này trở nên nguy hiểm khi đứng cạnh những quyền hành động nào khác?
6. Tác vụ dài cần cả giới hạn lẫn dấu vết
Một agent có quyền hợp lý vẫn có thể gây vấn đề nếu nó chạy vòng lặp quá lâu, retry không ngừng hoặc tạo số lượng lớn tool call. Các runtime hiện hành thường cung cấp nhiều loại giới hạn khác nhau. Agents SDK, chẳng hạn, có max_turns, timeout cho model call, usage tracking và control liên quan tới tool execution. Đây chỉ là feature của một framework cụ thể, không phải baseline chuẩn của mọi agent. (OpenAI Agents SDK — Running agents, Models) Ở lớp thiết kế, điều quan trọng hơn tên API là xác định tài nguyên nào cần có giới hạn. Một agent có thể cần giới hạn:
- số vòng lặp;
- tổng thời gian;
- token/model usage;
- số tool call;
- concurrency;
- API rate;
- tiền hoặc quota;
- CPU/memory;
- network access hoặc data transfer.
Không phải hệ thống nào cũng cần tất cả các giới hạn này. Nhưng “agent sẽ tự biết khi nào đủ” là một stop condition yếu nếu quy trình có thể tiêu tốn resource thật. Với tác vụ dài, giới hạn chỉ cho ta biết khi nào phải dừng hoặc chặn thêm workload. Ta còn cần biết trước lúc đó agent đã làm gì. Một tracing system có thể ghi model generation, tool call, handoff và guardrail để developer reconstruct run khi có sự cố. Nhưng cùng loại trace đó cũng có thể chứa prompt, tool input/output hoặc dữ liệu nhạy cảm; OpenAI Agents SDK, chẳng hạn, có setting để tắt capture sensitive data trong generation/function span. (OpenAI Agents SDK — Tracing) Vì vậy observability có hai mặt:
- quá ít dấu vết → khó biết action nào đã xảy ra;
- log mọi thứ → telemetry có thể trở thành một surface chứa dữ liệu nhạy cảm.
Observability giúp biết điều gì đã xảy ra. Nó không làm một action trái phép trở thành hợp lệ.
7. Với tác vụ dài, cancel không có nghĩa là undo
Agent chạy dài thêm một bài toán mà agent ngắn thường ít gặp: hệ thống có thể restart, mạng có thể lỗi, approval có thể tới sau nhiều giờ và một số tác động đã xảy ra trước khi workflow dừng. Bản MCP 2026-07-28 đã phát hành chính thức ngày 28/7/2026 và chuyển long-running work sang Tasks extension. Extension này định nghĩa task handle cùng các operation như tasks/get, tasks/update và tasks/cancel; trang specification của extension hiện vẫn mang nhãn Draft, vì vậy đây là một protocol mechanism đang phát triển chứ không phải universal baseline cho mọi agent system. (MCP — The 2026-07-28 Specification, MCP Tasks extension) Các agent runtime khác cũng có thể tích hợp durable workflow systems cho long wait, retry hoặc process restart. Điểm quan trọng không phải chọn đúng một orchestrator mà là tách ba việc:
Stop: không làm thêm bước mới.
Resume: tiếp tục từ trạng thái đã biết.
Recovery: xử lý trạng thái và tác động đã xảy ra trước khi lỗi/dừng.
Ví dụ, một agent đã gọi API tạo ticket thành công nhưng mất kết nối trước khi nhận response. Nếu workflow đơn giản retry cùng request, nó có thể tạo ticket thứ hai. Đó là lý do cần biết action có idempotent hay không — tức lặp lại cùng operation có giữ một kết quả logic tương đương hay tạo thêm side effect. Một implementation case khác: OpenAI Agents SDK hiện có replay-safety checks cho một số failure path và fail closed trong những tình huống recovery không thể xác định là an toàn; tài liệu cũng nói rõ việc chấp nhận unsafe replay có thể lặp lại provider-side work. (OpenAI Agents SDK — Models, Results) Bài học rộng hơn là:
Retry policy phải hiểu tác động của bước đang được retry.
Và ngay cả khi hệ thống có nút cancel, tác động đã hoàn tất trước thời điểm cancel không tự biến mất. Với hành động quan trọng, contract cần nói rõ liệu có rollback, compensation, manual recovery hay chỉ có thể ghi nhận trạng thái rồi dừng.
8. Áp Capability Contract vào một coding agent
Hãy lấy một case cụ thể: agent nhận yêu cầu sửa bug trong repository, tự đọc code, chỉnh file, chạy test và cuối cùng mở pull request. Nếu chỉ mô tả “agent có filesystem, shell và GitHub tool”, ta vẫn chưa biết nhiều về safety. Đi qua Capability Contract sẽ cho một thiết kế rõ hơn.
Bước 1 — đọc repository
Quyền hạn: chỉ repository/workspace liên quan. Ranh giới thực thi: working copy hoặc sandbox. Tác động: chỉ đọc. Cổng kiểm soát: thường không cần approval nếu user đã chọn đúng repo và policy cho phép. Giới hạn: có thể giới hạn file/context hoặc thời gian scan nếu repo lớn. Dấu vết: file/path nào đã được đọc ở mức cần thiết cho debug. Phục hồi: failure thường có thể retry vì chưa tạo external side effect.
Bước 2 — sửa file và chạy test
Quyền hạn: ghi trong working tree, không phải arbitrary host path. Ranh giới thực thi: sandbox có filesystem/network được scope theo nhu cầu. Tác động: thay đổi workspace; shell command còn có thể có tác động khác tùy command. Cổng kiểm soát: policy/command validation quan trọng hơn việc hỏi user cho từng lần ghi file. Giới hạn: timeout test, process/concurrency và network nếu cần. Dấu vết: diff, command, exit code và test result. Phục hồi: working tree có thể reset hoặc snapshot nếu architecture hỗ trợ.
Bước 3 — mở pull request
Đây là một trust transition khác. Quyền hạn: credential chỉ đủ cho repository và action cần thiết. Ranh giới thực thi: API call ra external service. Tác động: tạo artifact bên ngoài, có thể gửi notification và kích hoạt automation. Cổng kiểm soát: tùy workflow, có thể cho phép tự tạo draft PR nhưng yêu cầu approval trước merge; đây là product policy, không phải universal rule. Giới hạn: API rate/quota. Dấu vết: commit/diff, target branch, PR metadata và actor. Phục hồi: đóng PR có thể khôi phục một phần trạng thái, nhưng notification hoặc workflow downstream có thể đã chạy. Điểm quan trọng nhất của ví dụ này là agent không cần cùng một mức quyền từ đầu đến cuối. Nếu agent con được dùng để chạy test hoặc review code, delegation cũng không nên mặc nhiên mở rộng quyền vượt khỏi contract mà bước đó cần. Đây là recommendation kiến trúc của Học Tech, không phải một protocol requirement chung.
9. Checklist: trước khi cấp một quyền hành động cho agent
Khi nhìn vào bất kỳ agent workflow nào, có thể bắt đầu bằng bảy câu hỏi:
- Agent thực sự được quyền làm gì, dưới danh tính và phạm vi nào?
- Action chạy ở đâu, và môi trường đó nhìn thấy filesystem, network, data hay secret nào?
- Action tạo tác động gì; nếu chạy hai lần thì chuyện gì xảy ra?
- Policy, validation hoặc human approval nằm ở đâu trước tác động quan trọng?
- Task có giới hạn tài nguyên và stop condition nào?
- Sau sự cố, có đủ dấu vết để reconstruct chuyện gì đã xảy ra mà không vô tình log quá nhiều dữ liệu nhạy cảm không?
- Cancel, retry, resume và recovery thực sự có semantics gì?
Không có một cấu hình duy nhất đúng cho mọi agent. Một assistant chỉ tìm tài liệu có thể chấp nhận boundary khác với coding agent; coding agent lại khác agent được quyền gọi API tài chính hoặc thay đổi production system. Nhưng mô hình tư duy có thể giữ nguyên:
Model có thể đề xuất hành động. Ranh giới của hệ thống quyết định hành động nào được phép trở thành tác động thật — với quyền gì, ở đâu, trong giới hạn nào và có đường dừng/phục hồi ra sao.
Vì vậy, xây agent an toàn không có nghĩa là kỳ vọng model sẽ “không bao giờ quyết định sai”. Với mỗi quyền hành động, hệ thống cần xác định rõ quyền hạn, nơi thực thi, tác động, cổng kiểm soát, giới hạn tài nguyên, dấu vết và đường dừng/phục hồi. Mục tiêu là để ngay cả khi model hiểu sai, bị nội dung bên ngoài steer sai hoặc một tác vụ dài thất bại giữa chừng, một quyết định sai cũng không tự động trở thành quyền hành động không giới hạn.