Vì sao cuộc đua AI đang chuyển từ một GPU sang cả một rack?
Khi workload AI vượt khỏi một bộ tăng tốc, hiệu năng và hiệu quả kinh tế phụ thuộc vào cả hệ thống: bộ nhớ, interconnect, mạng, điện, làm mát và phần mềm.
Nhiều năm qua, cách dễ nhất để kể về cuộc đua hạ tầng AI là bắt đầu từ một con chip: GPU mới có bao nhiêu bộ nhớ, bao nhiêu FLOPS và nhanh hơn thế hệ trước bao nhiêu. Nhưng các đợt giới thiệu nền tảng lớn trong năm 2026 cho thấy câu chuyện đang rộng ra. NVIDIA giới thiệu Vera Rubin như một nền tảng tích hợp CPU, GPU, bộ chuyển mạch NVLink, giao tiếp mạng và DPU; ở cấp rack, NVL72 kết hợp 72 Rubin GPU với 36 Vera CPU và tách rõ kết nối scale-up với mạng scale-out. AMD cũng đưa Helios ra như một thiết kế tham chiếu rack-scale tích hợp GPU Instinct, EPYC CPU, networking, power, cooling và ROCm. AMD hiện nói rõ Helios là reference design cho OEM/ODM, không phải một sản phẩm rack mà AMD bán trực tiếp; Reuters đã đưa tin các hệ thống dựa trên Helios bước vào giai đoạn sản xuất và dự kiến giao trong nửa cuối năm 2026. (NVIDIA Vera Rubin NVL72, AMD Helios, Reuters) Điều đáng chú ý không phải GPU đã hết quan trọng. Trong những nền tảng đang bàn ở đây, bộ tăng tốc vẫn đảm nhiệm phần tính toán AI chính. Thay đổi nằm ở chỗ khác: khi model và workload phải trải qua nhiều thiết bị, hiệu năng của một chip đơn lẻ không còn đủ để nói hệ thống thực sự chạy nhanh, dùng tài nguyên hiệu quả hay dễ triển khai đến đâu. Cuộc đua vì thế đang mở rộng từ chip sang cả hệ thống.
Khi một GPU không còn đủ để mô tả hệ thống
Một bộ tăng tốc (accelerator) có hai tài nguyên cốt lõi: năng lực tính toán và bộ nhớ cục bộ. Nếu model vừa với một thiết bị và thông lượng (throughput) cần thiết không quá lớn, đánh giá ở cấp GPU vẫn rất hữu ích. Vấn đề xuất hiện khi workload vượt khỏi ranh giới đó. Trong huấn luyện phân tán (distributed training), PyTorch FSDP2 có thể chia parameters, gradients và optimizer state qua nhiều GPU để giảm lượng bộ nhớ mỗi thiết bị phải giữ. Đổi lại, hệ thống cần các phép truyền dữ liệu tập thể như all-gather và reduce-scatter. PyTorch mô tả trực tiếp trade-off này: sharding giúp giảm memory footprint, nhưng communication trở thành một phần của đường đi thực thi và cần được phối hợp với computation. (PyTorch FSDP2) Nói đơn giản: một khi bài toán bị chia ra, dữ liệu phải di chuyển và các thiết bị phải phối hợp. Từ đó, peak FLOPS của từng GPU chỉ còn là một phần của câu chuyện. Nếu accelerator phải chờ dữ liệu, chờ đồng bộ hoặc bị giới hạn bởi bộ nhớ và mạng, khả năng tính toán rất cao trên giấy không tự chuyển thành throughput tương ứng trong workload thực tế. CPU cũng không đứng ngoài bức tranh này. Vera Rubin ghép Vera CPU với Rubin GPU; Helios ghép EPYC CPU với Instinct GPU và networking. Vai trò cụ thể của CPU khác nhau theo kiến trúc và workload, nhưng việc các rack-scale platform tích hợp CPU cùng accelerator cho thấy bài toán không còn chỉ là chọn một GPU riêng lẻ. (NVIDIA Vera Rubin NVL72, AMD Helios)
Mental model: từ accelerator đến hệ thống phân tán
Có thể hình dung quá trình mở rộng theo các ranh giới sau:
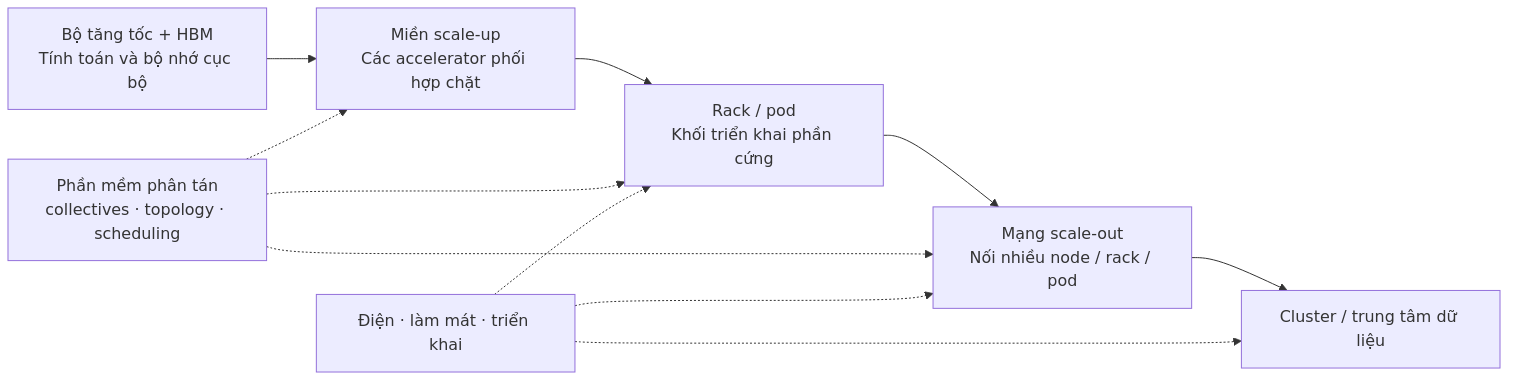
Sơ đồ này cố ý tách scale-up domain khỏi rack. Hai khái niệm không phải lúc nào cũng trùng nhau. Trong một số thiết kế, scale-up domain nằm gọn trong một rack; trong thiết kế khác, domain có thể trải qua nhiều chassis hoặc mở rộng hơn một rack. Vì vậy, “rack-scale” nên được hiểu là một khối sản phẩm và triển khai quan trọng, không phải ranh giới tính toán cuối cùng. Mỗi lần workload đi qua một ranh giới mới, một nhóm bottleneck mới có thể xuất hiện. Ở một accelerator, trọng tâm là compute và memory. Khi nhiều accelerator phải phối hợp chặt, bandwidth và latency của interconnect trở nên quan trọng. Khi hệ thống tiếp tục mở rộng ra nhiều node hoặc rack, mạng scale-out phải xử lý nhiều endpoint và luồng dữ liệu hơn. Khi mật độ phần cứng tăng, cấp điện, làm mát và khả năng triển khai trở thành điều kiện để compute thực sự dùng được.
Scale-up và scale-out không phải cùng một bài toán
Hai thuật ngữ dễ bị gom chung khi nói về AI networking là scale-up và scale-out. Scale-up là lớp kết nối các accelerator cần trao đổi dữ liệu thường xuyên và phối hợp chặt với nhau. Ở đây bandwidth rất cao và latency thấp có thể quyết định việc nhiều accelerator có hoạt động hiệu quả như một miền tính toán chung hay không. NVIDIA dùng NVLink/NVSwitch cho scale-up domain của mình. UALink là một chuẩn mở khác nhắm trực tiếp vào accelerator scale-up connectivity; specification 200G 1.0 công bố khả năng hỗ trợ tới 1.024 accelerator trong một AI computing pod. Đây là phạm vi kiến trúc của chuẩn, không phải bằng chứng rằng mọi deployment thực tế đều chạy ở quy mô đó. (UALink specification, NVIDIA Vera Rubin NVL72) Scale-out giải quyết lớp khác: nối nhiều node, rack hoặc pod thành cluster lớn hơn. Khi số endpoint và luồng dữ liệu tăng, các vấn đề như congestion, multipathing và tail latency trở nên quan trọng hơn. Ultra Ethernet Consortium định vị UEC cho backend scale-out của AI/HPC ở quy mô lớn. (Ultra Ethernet Consortium) Điểm cần giữ lại là: scale-up giúp các accelerator gần nhau phối hợp chặt; scale-out giúp nhiều khối tính toán nối thành hệ thống lớn hơn. Đó cũng là lý do rack không phải ranh giới cuối cùng. Một rack có thể là building block rất quan trọng, nhưng những cluster lớn hơn vẫn phải nối nhiều building block lại với nhau.
Training và inference tạo áp lực khác nhau
Một lỗi dễ mắc là nói “AI workload” như thể huấn luyện (training) và suy luận (inference) gây áp lực lên hạ tầng theo cùng một cách. Trong distributed training, synchronization và collective communication thường nằm trực tiếp trên đường thực thi quan trọng. Khi parameters, gradients hoặc optimizer state được shard qua nhiều accelerator, dữ liệu phải được trao đổi và tổng hợp giữa các worker. Cách chia model, chia dữ liệu, topology và khả năng chồng lấp communication với compute đều ảnh hưởng đến hiệu năng thực tế. (PyTorch FSDP2) Inference có một profile khác. Với large language model, weights phải nằm trong memory hoặc được phân chia qua nhiều thiết bị; đồng thời KV cache tăng theo số request, context và quá trình sinh token. Paper về PagedAttention, nền tảng cho vLLM, chỉ ra rằng KV cache lớn và biến động có thể làm lãng phí memory nếu quản lý kém, từ đó hạn chế batch size và throughput. (PagedAttention / vLLM) Điều này không cho phép kết luận rằng “inference cần rack-scale”. Khi một model và mức tải mục tiêu phù hợp với một accelerator hoặc một node, scale ra cả rack có thể không cần thiết. Rack-scale trở nên đáng quan tâm hơn khi model vượt quá tài nguyên cục bộ, throughput cần tăng mạnh, hoặc operator phải tối ưu cả một fleet thay vì một card riêng lẻ. Ở đây economics cũng đổi đơn vị. Giá hay peak performance của một GPU vẫn quan trọng, nhưng operator còn phải quan tâm accelerator có được sử dụng hiệu quả hay không, thời gian mất cho communication, memory có đủ cho workload không, hệ thống cần bao nhiêu điện và cooling, và có thể triển khai ở mật độ nào. Không có một công thức universal cho “chi phí mỗi token” hay “tokens trên mỗi megawatt”. Những con số đó phụ thuộc model, precision, context length, batch, utilization, topology và system boundary. Vì vậy các benchmark hoặc claim do vendor công bố chỉ có ý nghĩa khi đọc kèm workload, configuration, methodology và assumptions.
Khi điện và làm mát trở thành một phần của kiến trúc
Một rack AI chỉ có giá trị nếu data center có thể cấp điện cho nó, đưa nhiệt ra khỏi nó và vận hành nó ổn định. AMD Helios là một ví dụ rõ. Thiết kế này không chỉ ghép GPU và CPU; AMD còn mô tả power shelf tập trung, liquid-cooling manifold và các kết nối tích hợp nhằm giảm việc recabling khi thay thế sled. Những chi tiết đó cho thấy power delivery, thermal design và serviceability đang được giải quyết ở cấp platform thay vì để hoàn toàn cho bước triển khai sau cùng. (AMD Helios) NVIDIA cũng mô tả Vera Rubin NVL72 như một rack-scale platform với thiết kế modular tray và một hệ sinh thái triển khai đi kèm. (NVIDIA Vera Rubin NVL72) Từ đây xuất hiện một hệ quả quan trọng: tăng compute density mà không giải quyết power và cooling chỉ có thể chuyển bottleneck từ silicon sang facility. Vì vậy, khi competition dịch lên cấp rack, power và cooling không còn là chi tiết phụ của data center. Chúng trở thành một phần của câu hỏi “hệ thống này có triển khai và vận hành được ở mật độ mong muốn hay không?”.
Phần mềm quyết định phần cứng có phối hợp được hay không
Một hệ thống có nhiều accelerator, switch và đường truyền vẫn chưa tự động trở thành một “máy AI” hiệu quả. Phần mềm phân tán phải quyết định dữ liệu được chia như thế nào, collective nào được dùng, communication có thể overlap với computation hay không, và workload được đặt lên topology nào. PyTorch cung cấp các primitive và framework cho distributed training; NCCL và RCCL là hai thư viện communication đại diện trong hệ sinh thái NVIDIA và AMD. (PyTorch Distributed, NVIDIA NCCL, AMD RCCL) Điều này tạo ra một khác biệt quan trọng giữa peak capability và realized performance. Hai hệ thống có thể có accelerator mạnh, nhưng nếu data movement, topology mapping, scheduling hoặc collective implementation không phù hợp với workload, phần compute đó khó được khai thác đầy đủ. Nói cách khác, hardware chỉ có giá trị khi vừa vận hành được về mặt vật lý, vừa phối hợp được về mặt logic.
Rack-scale còn là bài toán triển khai và bảo trì
Khi một hệ thống gồm hàng chục accelerator, CPU, switch, power shelf và đường làm mát, việc thay thế một thành phần hay đưa cả rack vào data center không còn giống cắm thêm một card PCIe. Đó là lý do vendor ngày càng nói về reference design, modular tray, integrated cabling, serviceability và deployment ecosystem. AMD mô tả Helios như blueprint cho OEM/ODM xây hệ thống riêng; NVIDIA nhấn mạnh thiết kế modular và hệ sinh thái đối tác cho NVL72. (AMD Helios, NVIDIA Vera Rubin NVL72) Đây không chỉ là câu chuyện tiện lợi cho kỹ sư vận hành. Nếu một hệ thống mất nhiều thời gian để tích hợp, cấp điện, làm mát, kết nối hoặc sửa chữa, economics thực tế của nó cũng thay đổi. Vì vậy “deployment” là một phần của competitive unit mới: không chỉ chip chạy được bao nhiêu, mà còn hệ thống có thể được đưa vào vận hành ổn định nhanh và ở quy mô nào.
NVIDIA và AMD đang cạnh tranh ở đâu thật sự?
Nếu nhìn NVIDIA Vera Rubin và AMD Helios như một bảng benchmark trực tiếp, rất dễ đi sai hướng. Hai vendor công bố peak FLOPS, bandwidth, memory capacity và nhiều performance claim khác nhau. Nhưng các con số đó có thể dùng datatype, workload, model, sequence length, system boundary và assumptions khác nhau. AMD cũng ghi rõ một số claim của Helios dựa trên peak theoretical performance và configuration của system manufacturer có thể thay đổi; NVIDIA gắn nhiều inference claim với workload và configuration cụ thể. (AMD Helios, NVIDIA Vera Rubin NVL72) Vì vậy bài này không dùng chúng để kết luận ai “nhanh hơn”. Điều hai case thực sự cho thấy là phạm vi cạnh tranh đang rộng hơn:
- accelerator và memory vẫn là nền tảng;
- scale-up fabric quyết định nhiều accelerator phối hợp gần nhau ra sao;
- scale-out network quyết định các rack/node nối thành cluster như thế nào;
- CPU và networking trở thành thành phần của platform;
- power và liquid cooling được tích hợp vào rack design;
- software stack quyết định hardware được khai thác như thế nào;
- reference design, modularity và serviceability ảnh hưởng đến việc hệ thống có thể triển khai thực tế hay không.
Đó là cạnh tranh ở cấp system architecture, không chỉ ở cấp transistor hay GPU card.
Nhưng “rack-scale” cũng có giới hạn
Cụm từ rack-scale dễ tạo cảm giác rack đã trở thành “máy tính mới” thay thế hoàn toàn GPU. Cách hiểu đó quá mạnh. Thứ nhất, rack là ranh giới vật lý và deployment hữu ích, nhưng không phải lúc nào cũng trùng với ranh giới logic của workload. Scale-up domain có thể khác rack; cluster còn có thể lớn hơn nhiều rack. Thứ hai, không phải workload nào cũng cần đi đến quy mô đó. Một model nhỏ, một dịch vụ có traffic vừa phải hoặc một workload đã được quantize có thể chạy phù hợp trên một GPU hay một node. Thứ ba, bottleneck không cố định. Với workload này, memory có thể quan trọng nhất; với workload khác, network, latency, power hay software mới là giới hạn nổi bật. Vì vậy không nên nói “bottleneck đã chuyển từ GPU sang network” như một quy luật chung. Chính xác hơn là tập bottleneck đã mở rộng khi workload vượt ra ngoài một thiết bị.
Cách đọc cuộc đua AI từ bây giờ
Nếu chỉ nhìn thông số của một GPU, chúng ta vẫn biết rất nhiều về năng lực của một thành phần quan trọng. Nhưng với những workload phải phân tán qua nhiều thiết bị, câu hỏi cần rộng hơn: Dữ liệu nằm ở đâu? Phải di chuyển qua bao nhiêu lớp kết nối? Các accelerator đồng bộ với nhau như thế nào? Hệ thống cần bao nhiêu điện và cooling? Phần mềm có giữ các thiết bị bận làm việc không? Và cả hệ thống có thể được triển khai, vận hành và bảo trì ở quy mô nào? Đó là lý do cuộc đua AI đang chuyển từ việc chỉ nói về một GPU sang nói về cả rack — và từ rack sang cả cluster. GPU không biến mất khỏi trung tâm của câu chuyện. Nhưng khi workload vượt qua ranh giới của một chip, hiệu năng và economics trở thành thuộc tính của cả hệ thống xung quanh chip đó. Mental model có thể giữ lại là: compute → memory → scale-up → scale-out → power/cooling → software/operations Tên GPU sẽ thay đổi. Tên rack cũng sẽ thay đổi. Nhưng cách nhìn ở cấp hệ thống này có thể vẫn hữu ích lâu hơn nhiều.