Vì sao AI cần nhiều điện, chip và trung tâm dữ liệu?
Một ô chat AI phía trước được vận hành bởi cả một hệ thống vật lý phía sau: bộ tăng tốc, bộ nhớ, mạng, điện, làm mát và trung tâm dữ liệu.
Bạn gõ vài dòng vào một ô chat, nhấn gửi và vài giây sau nhận lại câu trả lời. Nhìn từ phía người dùng, trải nghiệm đó rất giống một phần mềm thông thường: có giao diện, có nút gửi, có nội dung trả về. Nhưng phần nhìn thấy chỉ là lớp ngoài cùng. Để tạo ra câu trả lời, một hệ thống AI phải chạy model trên phần cứng thật. Nó phải thực hiện rất nhiều phép tính, giữ và di chuyển dữ liệu qua bộ nhớ, đôi khi phối hợp nhiều thiết bị qua các kết nối tốc độ cao. Những thiết bị đó cần điện để hoạt động và tạo ra nhiệt phải được đưa ra khỏi hệ thống. Vì thế, nếu chỉ nhìn AI như một ứng dụng phần mềm, chúng ta sẽ bỏ qua phần hạ tầng vật lý quyết định rất nhiều đến khả năng và chi phí vận hành của nó.
1. Từ một prompt đến phần cứng phía sau
Khi người dùng nhấn gửi, prompt trước hết đi qua ứng dụng hoặc API rồi tới một dịch vụ inference — phần hệ thống chạy model đã được huấn luyện để tạo output cho người dùng. Ở tầng kỹ thuật, model phải thực hiện nhiều lớp tính toán để từng bước tạo ra câu trả lời. Người đọc không cần biết công thức của neural network để hiểu điều quan trọng nhất: một câu trả lời AI cuối cùng vẫn phải được tạo ra bằng phép tính trên phần cứng vật lý. Mental model cơ bản là: Prompt → ứng dụng/API → dịch vụ inference → phần cứng tính toán. Xung quanh phần cứng đó còn có bộ nhớ để giữ model và dữ liệu, mạng để các thiết bị trao đổi dữ liệu khi cần, cùng hệ thống cấp điện và làm mát để mọi thứ có thể hoạt động ổn định.
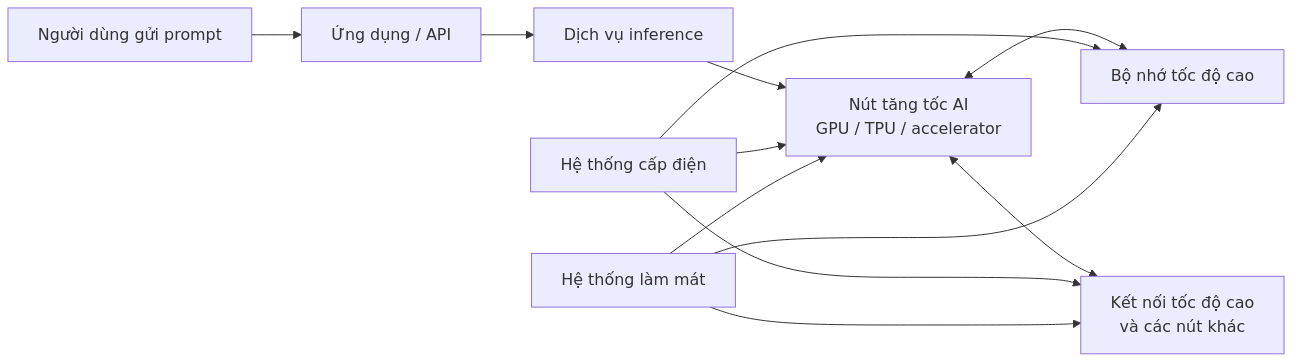
Sau khi phần tính toán hoàn tất, kết quả quay trở lại dịch vụ inference, rồi qua ứng dụng hoặc API để đến với người dùng. Điện và làm mát không phải hai “bước” chạy sau GPU; chúng là lớp hạ tầng bao quanh toàn bộ hệ thống tính toán.
2. Vì sao AI cần bộ tăng tốc — và tại sao chip mạnh vẫn chưa đủ?
Một layer của model có thể nhận rất nhiều giá trị đầu vào. Để tạo ra các giá trị tiếp theo, hệ thống phải thực hiện số lượng lớn phép nhân và phép cộng. Nhiều phép tính trong số đó có thể diễn ra song song. Đó là lý do GPU và các bộ tăng tốc AI (AI accelerator) trở nên quan trọng. CPU vẫn có thể chạy các tác vụ AI, nhưng accelerator được thiết kế để xử lý hiệu quả hơn những khối lượng phép tính có tính song song cao. Có thể hình dung thay vì một người xử lý lần lượt một danh sách phép tính dài, hệ thống có nhiều đơn vị tính toán cùng xử lý nhiều phần việc một lúc. Đây chỉ là hình dung trực quan; không nên hiểu rằng “mỗi core là một neuron” hay GPU là “hàng nghìn bộ não nhỏ”.
Một case để nhìn vào phần cứng thật
NVIDIA H100 SXM là một ví dụ có tài liệu kỹ thuật công khai rõ ràng. Theo NVIDIA, một H100 SXM có 80 GB bộ nhớ GPU và băng thông bộ nhớ 3,35 TB/s; kết nối NVLink có thể đạt 900 GB/s giữa các GPU. Những con số này không đại diện cho mọi accelerator, nhưng chúng cho thấy một điểm quan trọng: chip tính toán nhanh thôi chưa đủ — dữ liệu cũng phải được giữ và di chuyển đủ nhanh. NVIDIA H100 Đó là vai trò của băng thông bộ nhớ (memory bandwidth): tốc độ dữ liệu có thể được đưa giữa bộ nhớ và phần thực hiện phép tính. Nếu chip có khả năng tính rất nhanh nhưng phải chờ dữ liệu, một phần năng lực tính toán sẽ bị bỏ phí. Một hệ thống DGX H100, chẳng hạn, chứa 8 GPU H100 với tổng cộng 640 GB bộ nhớ GPU. Đây vẫn chỉ là một cấu hình cụ thể của NVIDIA, nhưng nó giúp minh họa rằng khi quy mô tác vụ tăng lên, bài toán không chỉ là “thêm chip”. Hệ thống còn cần đủ bộ nhớ và khả năng di chuyển dữ liệu giữa các thành phần. NVIDIA DGX H100/H200 Có thể tóm tắt phần này bằng một quan hệ đơn giản: Năng lực tính toán càng lớn thì khả năng đưa dữ liệu tới phần tính toán cũng phải theo kịp.
3. Khi một accelerator không đủ: mạng có thể trở thành nút thắt
Một accelerator có giới hạn về bộ nhớ và năng lực tính toán. Với một số tác vụ đủ lớn, hệ thống có thể cần chia công việc qua nhiều accelerator hoặc nhiều server. Khi đó xuất hiện một bài toán mới: các thiết bị phải trao đổi và đồng bộ dữ liệu với nhau. Nếu một phần của hệ thống phải chờ dữ liệu từ thiết bị khác, việc bổ sung thêm chip chưa chắc tạo ra mức tăng hiệu năng tương ứng. Vì thế, trong hệ thống AI phân tán, mạng không chỉ là đường kết nối server với Internet. Các kết nối giữa những thiết bị tính toán có thể trở thành nút thắt hiệu năng của cả tác vụ. Meta từng công bố hai cluster AI, mỗi cluster có 24.576 NVIDIA H100 GPU, cùng kiến trúc mạng với các kết nối 400 Gbps. Ở một tài liệu khác, Meta cho biết hạ tầng huấn luyện Llama 3.1 405B hoạt động trên hơn 16.000 H100 GPU. Những con số này cho thấy quy mô mà một số tác vụ huấn luyện lớn có thể đạt tới. Meta — Building GenAI Infrastructure, Meta — Open AI hardware vision Nhưng chúng không có nghĩa một prompt của người dùng đang chạy qua 16.000 hay 24.576 GPU. Đây là ví dụ về hạ tầng AI quy mô lớn, đặc biệt phù hợp khi nói về training phân tán. Mental model nên giữ là: Muốn mở rộng năng lực tính toán qua nhiều chip, hệ thống cũng phải mở rộng khả năng truyền dữ liệu giữa các chip.
4. Điện và nhiệt: cái giá vật lý của phép tính
Accelerator, CPU, bộ nhớ, thiết bị mạng và lưu trữ đều cần điện để hoạt động. Nhưng khi nói về điện của một data center, sẽ dễ hiểu hơn nếu tách thành hai lớp. IT load là phần thiết bị trực tiếp tính toán, lưu trữ và truyền dữ liệu: accelerator/GPU, CPU, memory, network và storage. Hạ tầng facility là lớp hỗ trợ quanh chúng: hệ thống làm mát, quạt hoặc bơm, phân phối và chuyển đổi điện, cùng các hệ thống vận hành khác. Không có một tỷ lệ chung kiểu “GPU luôn chiếm X%, cooling luôn chiếm Y%” cho mọi data center. Tỷ lệ thực tế thay đổi theo mức sử dụng phần cứng, mật độ thiết bị, kiến trúc làm mát, khí hậu và thiết kế của từng facility. H100 SXM, chẳng hạn, có mức TDP tối đa có thể cấu hình tới 700 W. Đây là thông số thiết kế/cấu hình của thiết bị, không phải khẳng định rằng mọi H100 luôn tiêu thụ đúng 700 W trong mọi tác vụ. NVIDIA H100
Vì sao phải làm mát?
Phần lớn điện năng mà thiết bị IT tiêu thụ cuối cùng phải được đưa ra khỏi facility dưới dạng nhiệt. Khi nhiều accelerator công suất cao được đặt gần nhau, việc loại bỏ nhiệt trở thành một yêu cầu hạ tầng quan trọng. Microsoft, chẳng hạn, mô tả các thiết kế data center AI mới sử dụng direct-to-chip liquid cooling theo vòng kín: chất lỏng đi tới gần chip để nhận nhiệt rồi được tuần hoàn lại trong hệ thống. Đây là một kiến trúc cụ thể của Microsoft, không phải thiết kế chung cho mọi data center. Microsoft — Water and cooling IEA cũng ghi nhận mật độ công suất của AI server đã tăng mạnh: theo báo cáo năm 2026, mức này tăng khoảng 11 lần từ 2020 đến 2025 và trong kịch bản trung tâm có thể tăng thêm khoảng bốn lần tới 2027. Điều đó làm bài toán hạ tầng không dừng ở chip, mà còn liên quan đến hệ thống điện và khả năng đưa nhiệt ra khỏi thiết bị. IEA — Key Questions on Energy and AI 2026
PUE cho biết điều gì?
Một chỉ số thường gặp khi nói về data center là PUE — Power Usage Effectiveness: PUE = tổng điện năng của data center / điện năng dùng bởi thiết bị IT. Nếu PUE = 1,2 và thiết bị IT dùng 100 đơn vị năng lượng, toàn facility dùng 120. Phần ngoài IT là 20 đơn vị, tức khoảng 16,7% của tổng 120 — không phải 20% tổng điện. PUE càng gần 1,0 thì phần điện ngoài IT load càng nhỏ. Nhưng PUE không cho biết riêng hệ thống cooling chiếm bao nhiêu, cũng không cho biết một model AI hiệu quả tới mức nào.
5. Data center là nơi các thành phần trở thành một hệ thống
Tới đây có thể thấy data center không đơn giản là một tòa nhà đặt nhiều GPU. Nó là nơi năng lực tính toán, bộ nhớ, mạng, lưu trữ, hệ thống cấp điện và làm mát phải hoạt động cùng nhau. Một accelerator mạnh cần bộ nhớ đủ nhanh để cung cấp dữ liệu. Một tác vụ trải trên nhiều thiết bị cần kết nối đủ tốt để các thiết bị phối hợp. Tất cả phần cứng đó lại cần nguồn điện ổn định và khả năng đưa nhiệt ra khỏi facility. Đó là vai trò cốt lõi của data center trong mental model của bài này: biến các thành phần phần cứng rời rạc thành một hệ thống có thể vận hành liên tục ở quy mô lớn. Quy mô điện của ngành data center cho thấy lớp hạ tầng này không còn là chi tiết phụ. Trong outlook cập nhật năm 2026, IEA dùng mức khoảng 485 TWh cho điện năng data center toàn cầu năm 2025 và dự báo con số này có thể tăng lên khoảng 950 TWh vào năm 2030. IEA cũng dự báo điện năng của các data center tập trung vào AI tăng nhanh hơn, khoảng gấp ba trong cùng giai đoạn. Đây là mốc 2025 và projection 2030 ở cấp toàn ngành data center, không phải số điện tiêu thụ của một prompt hay một model cụ thể. IEA — Key Questions on Energy and AI 2026
6. Training và inference tạo tải hạ tầng theo những cách khác nhau
Một nhầm lẫn quan trọng khi nói về hạ tầng AI là gộp training và inference thành cùng một tác vụ. Training là quá trình điều chỉnh các tham số của model từ dữ liệu. Với các model lớn, một lần training có thể kéo dài và được phân tán qua nhiều accelerator. Khi nhiều thiết bị cùng tham gia, việc trao đổi và đồng bộ dữ liệu giữa chúng có vai trò đặc biệt quan trọng. Các cluster GPU lớn mà Meta công bố là ví dụ phù hợp cho lớp tác vụ này. Meta — Building GenAI Infrastructure Inference thì khác. Model đã được huấn luyện và giờ được chạy để tạo output cho người dùng. Một request riêng lẻ có thể nhỏ hơn rất nhiều một lần training quy mô lớn, nhưng một dịch vụ AI phổ biến phải xử lý request liên tục từ nhiều người dùng. Có thể giữ một mental model đơn giản: Training tạo những đợt nhu cầu tính toán rất lớn để xây hoặc điều chỉnh model; inference biến năng lực tính toán thành một dịch vụ phải vận hành liên tục khi sản phẩm có người dùng. Cả hai đều phụ thuộc vào accelerator, bộ nhớ, mạng, điện và làm mát, nhưng cách chúng tạo tải lên hạ tầng không giống nhau. Vì thế, không thể lấy số liệu của một training cluster rồi áp trực tiếp cho “một câu hỏi AI”.
7. AI không chỉ là câu chuyện về model hay chip
Từ các ví dụ trên, có thể thấy một hệ thống AI quy mô lớn là chuỗi phụ thuộc giữa nhiều thành phần: tính toán ↔ bộ nhớ ↔ mạng ↔ điện ↔ làm mát ↔ năng lực data center. Nếu chip tính toán nhanh hơn nhưng bộ nhớ không theo kịp, phần tính toán có thể phải chờ dữ liệu. Nếu bổ sung thêm accelerator nhưng kết nối giữa chúng không đủ nhanh, tác vụ phân tán có thể bị giới hạn bởi truyền dữ liệu. Nếu mật độ phần cứng tăng nhưng cấp điện hoặc làm mát không đáp ứng, khả năng triển khai thực tế cũng bị giới hạn. Vì thế, nhìn AI chỉ qua benchmark của model hoặc số lượng GPU sẽ bỏ sót một phần quan trọng của bức tranh. Khả năng triển khai còn phụ thuộc vào việc toàn bộ hạ tầng quanh model có thể mở rộng tới đâu. Theo góc nhìn biên tập của Học Tech, cách hữu ích hơn để nhìn AI là: AI vừa là một bài toán phần mềm, vừa là một bài toán hạ tầng.
8. Bốn điều cần cẩn thận khi đọc các con số về AI
Mental model ở trên hữu ích, nhưng nó không cho phép biến một cấu hình hoặc một data center thành con số chung cho toàn bộ AI.
- Không có một con số Wh chung cho “một prompt AI”. Kết quả phụ thuộc vào model, phần cứng, cách phục vụ request, độ dài input/output, mức sử dụng hệ thống và ranh giới đo lường.
- H100 không phải phần cứng của mọi AI. Nó chỉ là một case có thông số công khai rõ ràng để minh họa accelerator, bộ nhớ, kết nối và công suất.
- Không có một tỷ lệ điện năng chung cho mọi data center. Phần dành cho IT, làm mát và các hệ thống phụ trợ thay đổi theo site, thiết kế và tác vụ.
- Projection không phải current fact. Con số IEA cho năm 2030 là dự báo, không phải mức tiêu thụ hiện tại.
Những giới hạn này quan trọng vì một con số đơn giản thường dễ nhớ hơn một hệ thống phức tạp — nhưng cũng rất dễ tạo ra mental model sai.
Vì sao một ô chat cuối cùng lại cần cả data center?
Một câu trả lời AI bắt đầu từ phần mềm, nhưng cuối cùng vẫn phải được tạo bằng phép tính trên phần cứng thật. Accelerator thực hiện các phép tính đó; bộ nhớ phải cung cấp dữ liệu đủ nhanh; khi nhiều thiết bị cùng tham gia, mạng phải giúp chúng phối hợp. Toàn bộ phần cứng ấy cần điện và tạo ra nhiệt phải được xử lý. Data center là nơi những thành phần đó trở thành một hệ thống có thể vận hành ở quy mô lớn. AI là phần mềm, nhưng khả năng và chi phí của nó được neo vào một hệ thống vật lý rất thật.